人工智能应用软件开发 从技术架构到落地实践的全面指南(附48页PDF资料)
引言
人工智能应用软件开发正在重塑软件工程的边界。与传统软件以确定性逻辑为核心不同,AI应用需要处理概率性输出、管理数据飞轮、协调模型训练与推理部署。本文从工程视角出发,系统梳理AI应用开发的关键环节,并附上48页PDF配套资料,供开发者深入学习与实践参考。
一、AI应用软件的架构层次
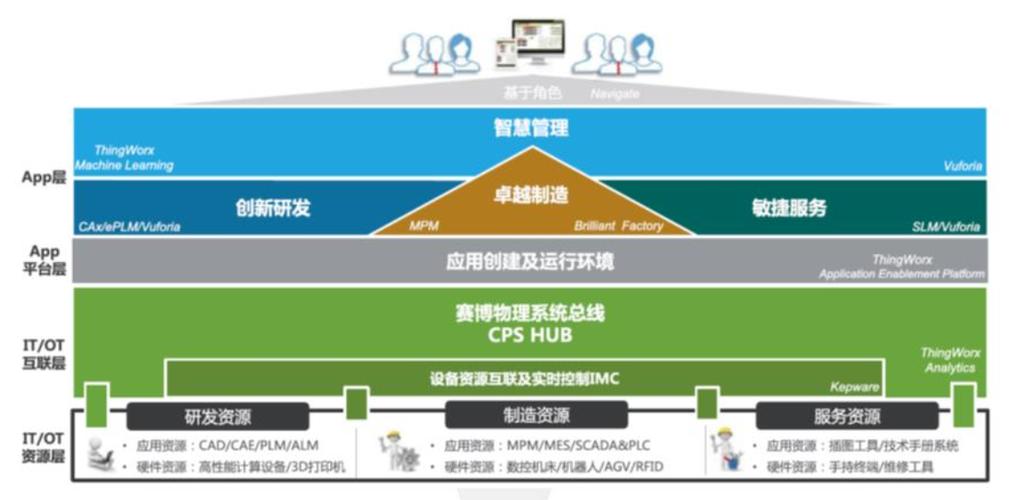
一个典型的AI应用可划分为四层架构:
1. 数据层
负责数据采集、清洗、标注与版本管理。数据质量直接决定模型上限,建议建立数据管道(Data Pipeline)并引入数据集版本控制工具(如DVC),确保训练数据可追溯、可复现。
2. 模型层
涵盖模型选型、微调训练与评估。开发者需在预训练大模型与自训练小模型之间做权衡:大模型泛化能力强但推理成本高;小模型适合垂直场景但需要充足领域数据。混合策略(如大模型蒸馏、LoRA微调)常是务实之选。
3. 服务层
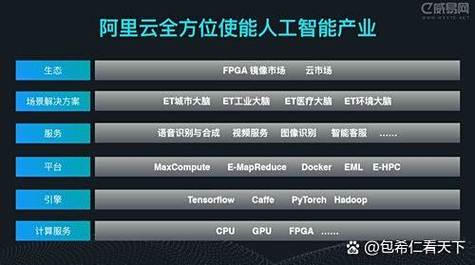
将模型封装为可调用的API服务,涉及推理加速(量化、批处理、GPU调度)、负载均衡与灰度发布。容器化部署(Docker + Kubernetes)和模型服务框架(如Triton、vLLM)是当前主流方案。
4. 应用层
面向最终用户的交互界面与业务逻辑,包括提示词工程、上下文管理、业务规则编排以及人机协作机制。此层决定了AI能力能否转化为真实的产品价值。
二、核心开发流程
需求定义与可行性评估:明确AI承担的具体任务,评估数据可得性、准确率要求与容错边界。并非所有问题都适合用AI解决,规则引擎在确定性场景下往往更可靠。
数据准备与标注:构建训练集、验证集与测试集,设计标注规范并保障标注一致性。对于LLM应用,还需构造高质量的指令数据集与评测基准。
模型开发与迭代:从基线模型出发,通过实验管理(如MLflow、WandB)跟踪训练过程,建立自动化评估流水线,避免“拍脑袋”式调参。
部署与监控:上线后持续监控模型性能漂移(Data Drift / Concept Drift)、延迟与成本指标。建立反馈闭环,将线上badcase回流至训练数据,驱动模型迭代。
三、关键技术选型建议
- 框架层面:PyTorch是研究与生产的主流选择;TensorFlow在部分企业遗留系统中仍有应用。
- 大模型应用:LangChain/LlamaIndex适合快速搭建RAG与Agent流程,但生产环境需关注其抽象层带来的调试复杂度,必要时下沉至原生API调用。
- 推理服务:vLLM在吞吐量上表现优异,Triton适合多框架混合部署,ONNX Runtime适合端侧与CPU场景。
- MLOps工具链:实验追踪用MLflow/WandB,特征管理用Feast,模型注册与部署用KServe或Seldon。
四、常见工程陷阱
- 忽视数据质量:模型效果不佳时过早归因于算法,实际多数问题源于数据标注噪声或分布偏差。
- 评估指标与业务目标脱节:离线指标(如准确率)提升不等于线上业务指标改善,需建立与业务对齐的评估体系。
- 缺乏回滚机制:模型更新导致线上事故时无法快速切回旧版本,应设计模型版本管理与一键回滚能力。
- 成本失控:大模型推理的token成本与GPU资源消耗容易被低估,需在架构设计阶段引入成本预算与限流策略。
五、配套PDF资料说明
随本文附上的48页PDF资料涵盖以下内容:AI应用架构设计模板、数据标注规范示例、模型评估检查清单、MLOps工具链对比表、主流推理框架性能基准数据,以及三个完整的AI应用开发案例(智能客服、文档问答、图像质检)。该资料可作为团队内部培训材料或项目启动参考。
##
AI应用软件开发的本质,是在不确定性中构建可靠的工程系统。技术选型会随生态演进不断变化,但数据治理、评估闭环与成本意识这三条工程原则具有长期价值。建议开发者以具体场景为锚点,小步验证、快速迭代,避免陷入“为AI而AI”的技术堆砌。
如若转载,请注明出处:http://www.browsingpay.com/product/56.html
更新时间:2026-11-15 23:05:57